01 · harness-optimization4,277 字 · 12 分钟
地图之外长文2026年11月1日
评分器才是优化器
我们让一个AI agent去改进另一个agent的harness。随后换一个更严格的评分器重新给同一批页面打分,每个harness测出的提升都缩水了三分之一到70%。在开放式任务上,优化器学到什么取决于评分器,而且学到的往往就是评分器本身。
文中的图表
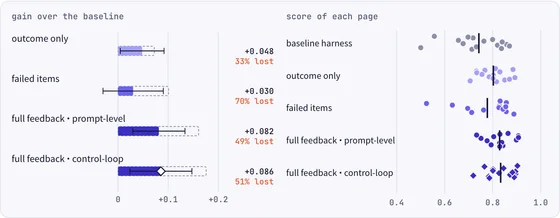
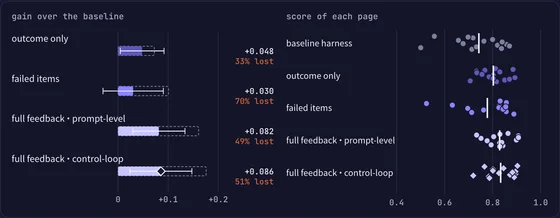
图 1交互
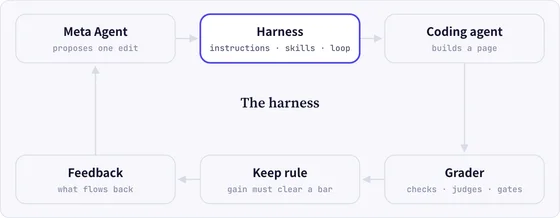
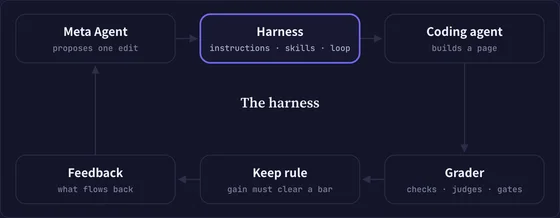
图 2交互
图 3
大纲
- 01这个循环是怎么运转的
- 02换一个评分器,提升缩水三分之一到70%
- 03运行之间的噪声,和你的保留门槛一样大
- 04给优化器看失败的评分项,它就会抄
- 05Reward hacking确实发生了,只是不以作弊的形式
- 06几乎所有提升都来自第一次修改
- 07看着循环跑:dashboard
- 08如果有人告诉你,他们的agent会自我改进
- 09给搭建这种循环的人的建议
EN · 中阅读 · 12 分钟